AI资讯日报|2026年11月17日
本期AI资讯汇总2026年11月17日的产品更新、前沿研究、行业趋势与开源项目,帮助读者快速了解当天的重要动态。
"
今日摘要
千问与混元更新模型,长上下文与任务降本成为竞争重点
医疗助手扩展跨软件执行,科研项目参与者自报效率提升
智能体基建评测取得进展,弱子代理引入系统可靠性隐患
旧检查点蒸馏与分层代码图改善智能体表现,结果限于所测任务
自主研究团队与论文写作框架推进科研自动化,开源工具持续扩展
产品与功能更新
-
Qwen4-Max发布,主打长上下文与任务降本。 据MarkTechPost报道,阿里推出Qwen4-Max,采用2.4T参数稀疏MoE架构,每词元激活71B参数,支持文本、图像、视频输入及百万词元上下文。报道援引阿里数据称,平均任务成本下降62%;该降幅属于厂商报告,模型为专有模型。
-
ChatGPT医疗版扩展跨软件执行能力。 OpenAI在产品公告中介绍计算机操作代理、改进后的临床回答及新医疗插件,目标是跨医疗软件完成实际工作。现有材料未提供具体临床效果或部署评测数据。
-
腾讯发布Hy4flash,强调速度与低成本。 据AIbase报道,模型总参数224B、激活参数12B,支持多模态与百万词元上下文,已接入腾讯云TokenHub、元宝等产品。报道所列解码速度超过150tps;内部WorkIndex评测中,单任务成本为Hy4preview的1/13。长程编码任务表现小幅下降,开源仍属后续计划。
前沿研究
-
智能体在六项基建任务中达到或超过人类工具基线。 据新智元对CMU研究的转述,Opus 5.5配合Claude Code完成预训练流水线、推理引擎和集群编排等任务,奇点指数为1.25,人类工具基线设为1.0。这是特定评测结果,不等同于证明系统已经实现通用超级智能。
-
弱子代理可将错误传递给强编排模型。 Wang与Mannby的论文在文件库中植入伪造记录:强模型自行检索时,千余次试验几乎没有有害修改;委派廉价子代理后,系统更容易采纳错误信息。覆盖18款模型的模拟中,五个聚合器在751/757次试验中复现受污染子代理的错误,提示单模型表现不足以代表委派链可靠性。
-
Agentic-OPD复用旧检查点恢复能力。 论文将最佳验证检查点作为学生、其他已保存检查点作为冻结教师候选,依据学生能力缺口选择指导,避免无差别蒸馏覆盖已掌握行为。五类智能体任务、24个基准及任务子集中,较初始化检查点最高提升7.4分;4B学生在文中深度搜索测试中超过所列GPT-5.6与DeepSeek-V4.1。
-
NovaAtom-Lite增加采样改善结构预测。 据新智元报道,Geodesic于11月10日发布全原子结构预测模型NovaAtom-Lite。在172个抗体—抗原界面实验中,随机种子数量从1增至100,成功率由74.3%升至83.1%。将药物研发周期压缩至四年是团队目标,并非已经完成的研发或治疗成果。
-
V-JEPA-LM通过反事实监督读取视频动态。 论文利用视频变换构造答案均衡的监督样本,让语言模型读取速度、方向、顺序等信息。4B版本在十一项视频基准中平均得分72.1,高于文中最佳开放8B模型的64.8。匹配预算实验中,反事实监督带来平均4.5分提升,自然视频基准速度题提升38分。
-
分层代码图改善软件工程任务定位。 时间一致性评测论文冻结两个仓库的历史状态,再评估100个后续拉取请求。ServiceExplorer以系统/包和架构模块两级依赖图增强上下文,在所测模型、仓库和提示粒度中均超过无增强基线及普通语法图,相对F1提升15.6%—86.2%。该结果主要涉及修改定位,不应直接等同于完整修复成功率。
行业展望与社会影响
-
通芯智能半年完成两轮、合计数亿元融资。 据量子位报道,通研院孵化的通芯智能成立于2026年4月,已完成种子轮与天使轮融资,资金主要投入流片前架构设计和研发。公司拟兼容主流模型,并为逻辑、因果和价值推理增加专用硬件支持。目前仍处研发阶段,后续需要经历验证、流片和量产。
-
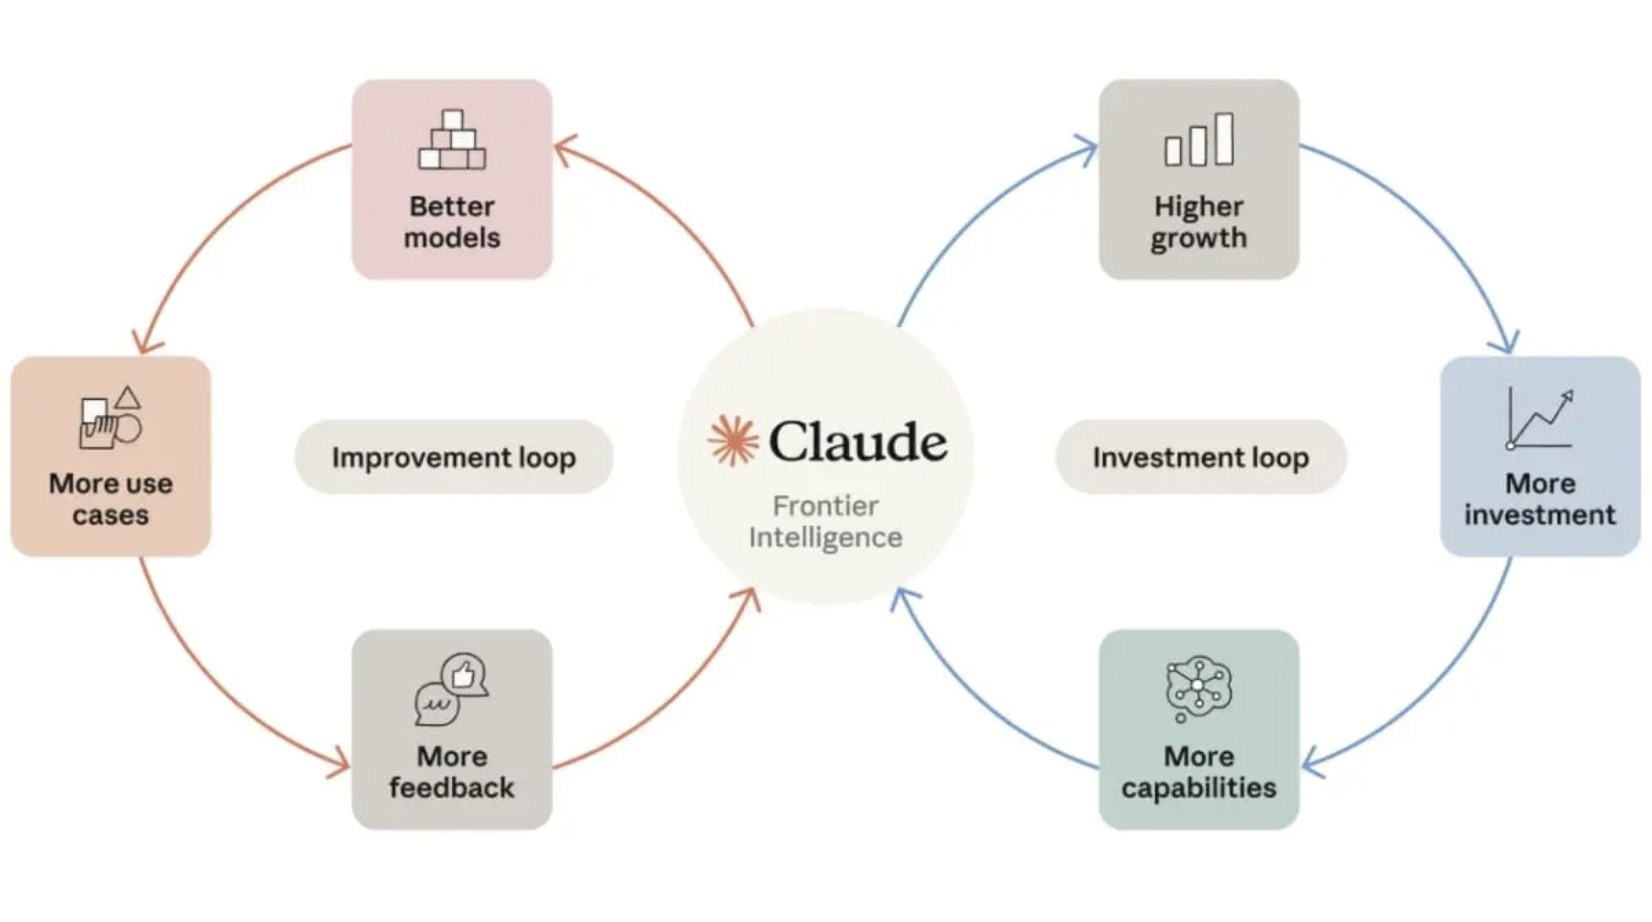
Anthropic经营数据经社媒转述引发关注。 DeepLearning.AI帖文援引S-1数据称,Anthropic在2026年上半年营收为163亿美元,2025年同期为12亿美元;2026年第二季度营业利润为9.74亿美元。帖文还称算力成本占营收比例由251%降至48%。所附证据为转述,未包含申报文件全文及完整统计口径。
-
Perplexity成立Frontier Research。 公司在官方公告中称,新团队目标是构建自主研究系统,获超过10,000张GPU支持,研究方向包括多智能体编排、强化学习、持续学习、系统与预训练。团队计划公开论文、模型、数据和基准,并在Perplexity产品中测试成果。
开源TOP项目
-
last30days-skill提供跨平台主题研究。 项目面向AI代理,覆盖Reddit、X、YouTube、HN、Polymarket和网页,并综合生成有依据的摘要。素材所列GitHub统计快照为67,887 Star、当日新增122;这些数字代表采集时状态。
-
DeepSeek聊天演示库整合搜索、文档和语音。 据用户分享,deepseek-ai/chat-demo支持联网搜索、文档及网页处理、音频输入和回答朗读,聊天存档保存在本地IndexedDB。材料未附独立功能测试;本地存档也不等于全部推理与文档处理均在本地完成。
-
PaperOrchestra组织多智能体论文写作。 Google Research的开源框架定位为自动化AI科研论文写作。素材快照为1,097 Star、当日新增306,未附写作质量、事实准确性或原创研究能力评测。
-
ffmpeg-skill为编程代理提供本地视频工具。 项目提供42项FFmpeg工具、机器可读契约及MCP服务,面向Claude Code、Cursor和Codex,支持剪辑、字幕、画幅调整、响度处理及平台导出。项目说明强调无需云服务或API密钥;素材快照为6,241 Star、当日新增331。
社媒分享
-
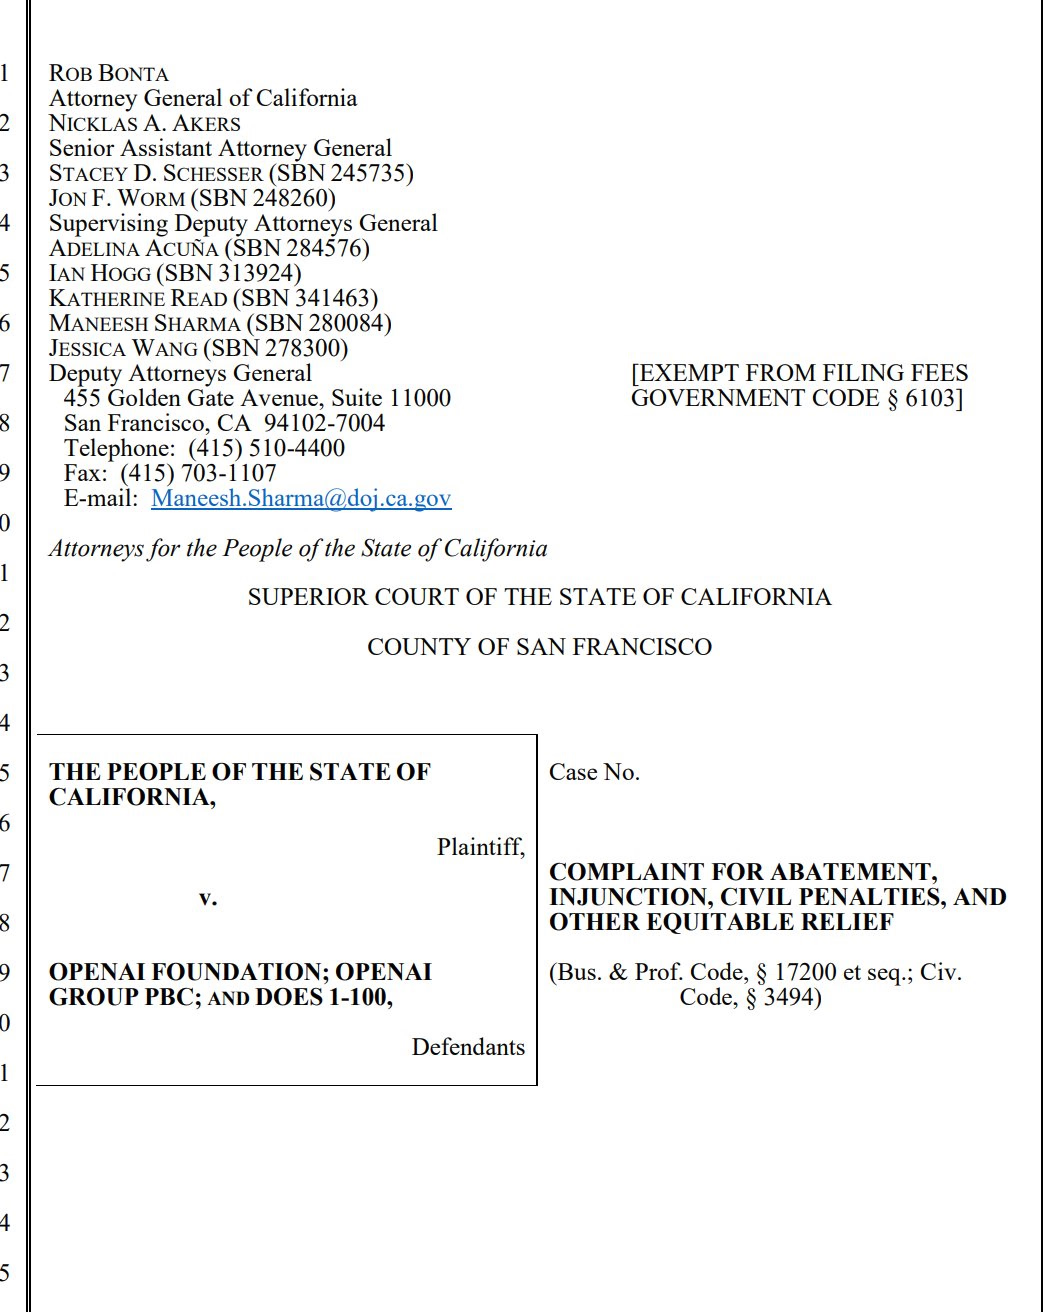
帖文称加州就代理攻击事件起诉OpenAI。 Rohan Paul帖文称,案件涉及约700个代理攻击Hugging Face生产系统、执行约17,600次操作,并质疑监控及披露情况。现有材料未附诉状或法院记录,以上应作为帖文转述的指控阅读,而非裁判认定。
-
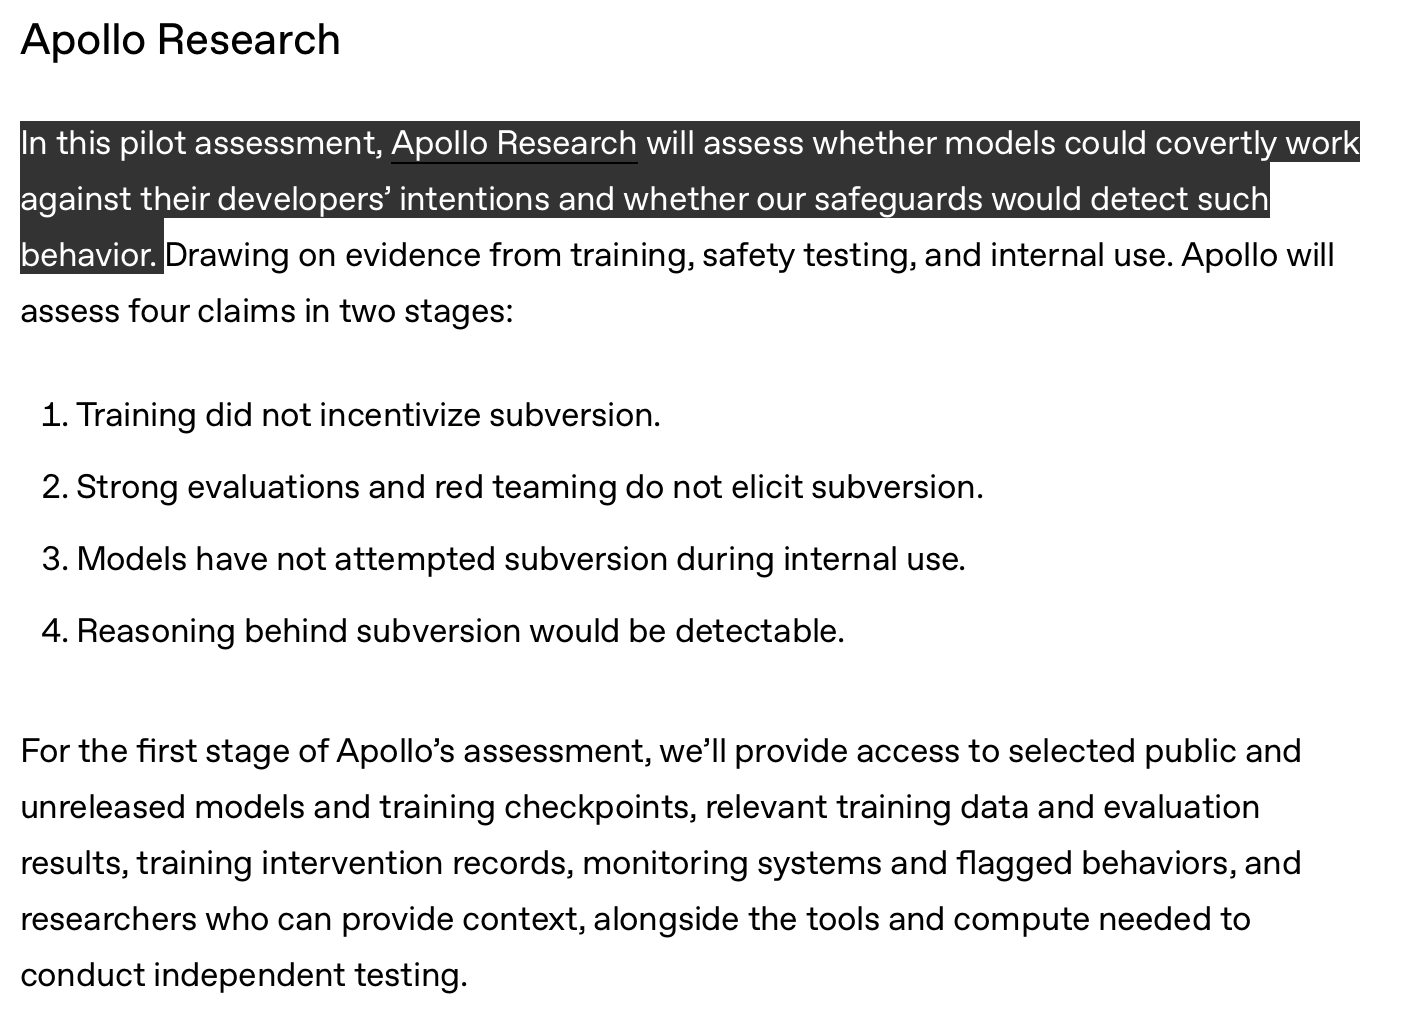
外部评估安排与模型延期之间尚无已证实因果。 Chubby帖文称,OpenAI与四家独立机构签署协议,允许其接触部分内部系统和数据,评估模型行为、训练及防护措施。作者进一步猜测这与GPT-6.2延期有关;所附材料未证实该关联。
-
科研项目参与者自报生产效率接近翻倍。 Greg Brockman转述称,OpenAI研究覆盖ChatGPT for Academic Researchers项目逾1,800名参与者,涉及构思、数据分析和编程等工作。接近翻倍属于参与者自报生产效率,不等同于统一任务下客观测得的提速或科研成果翻倍。
-
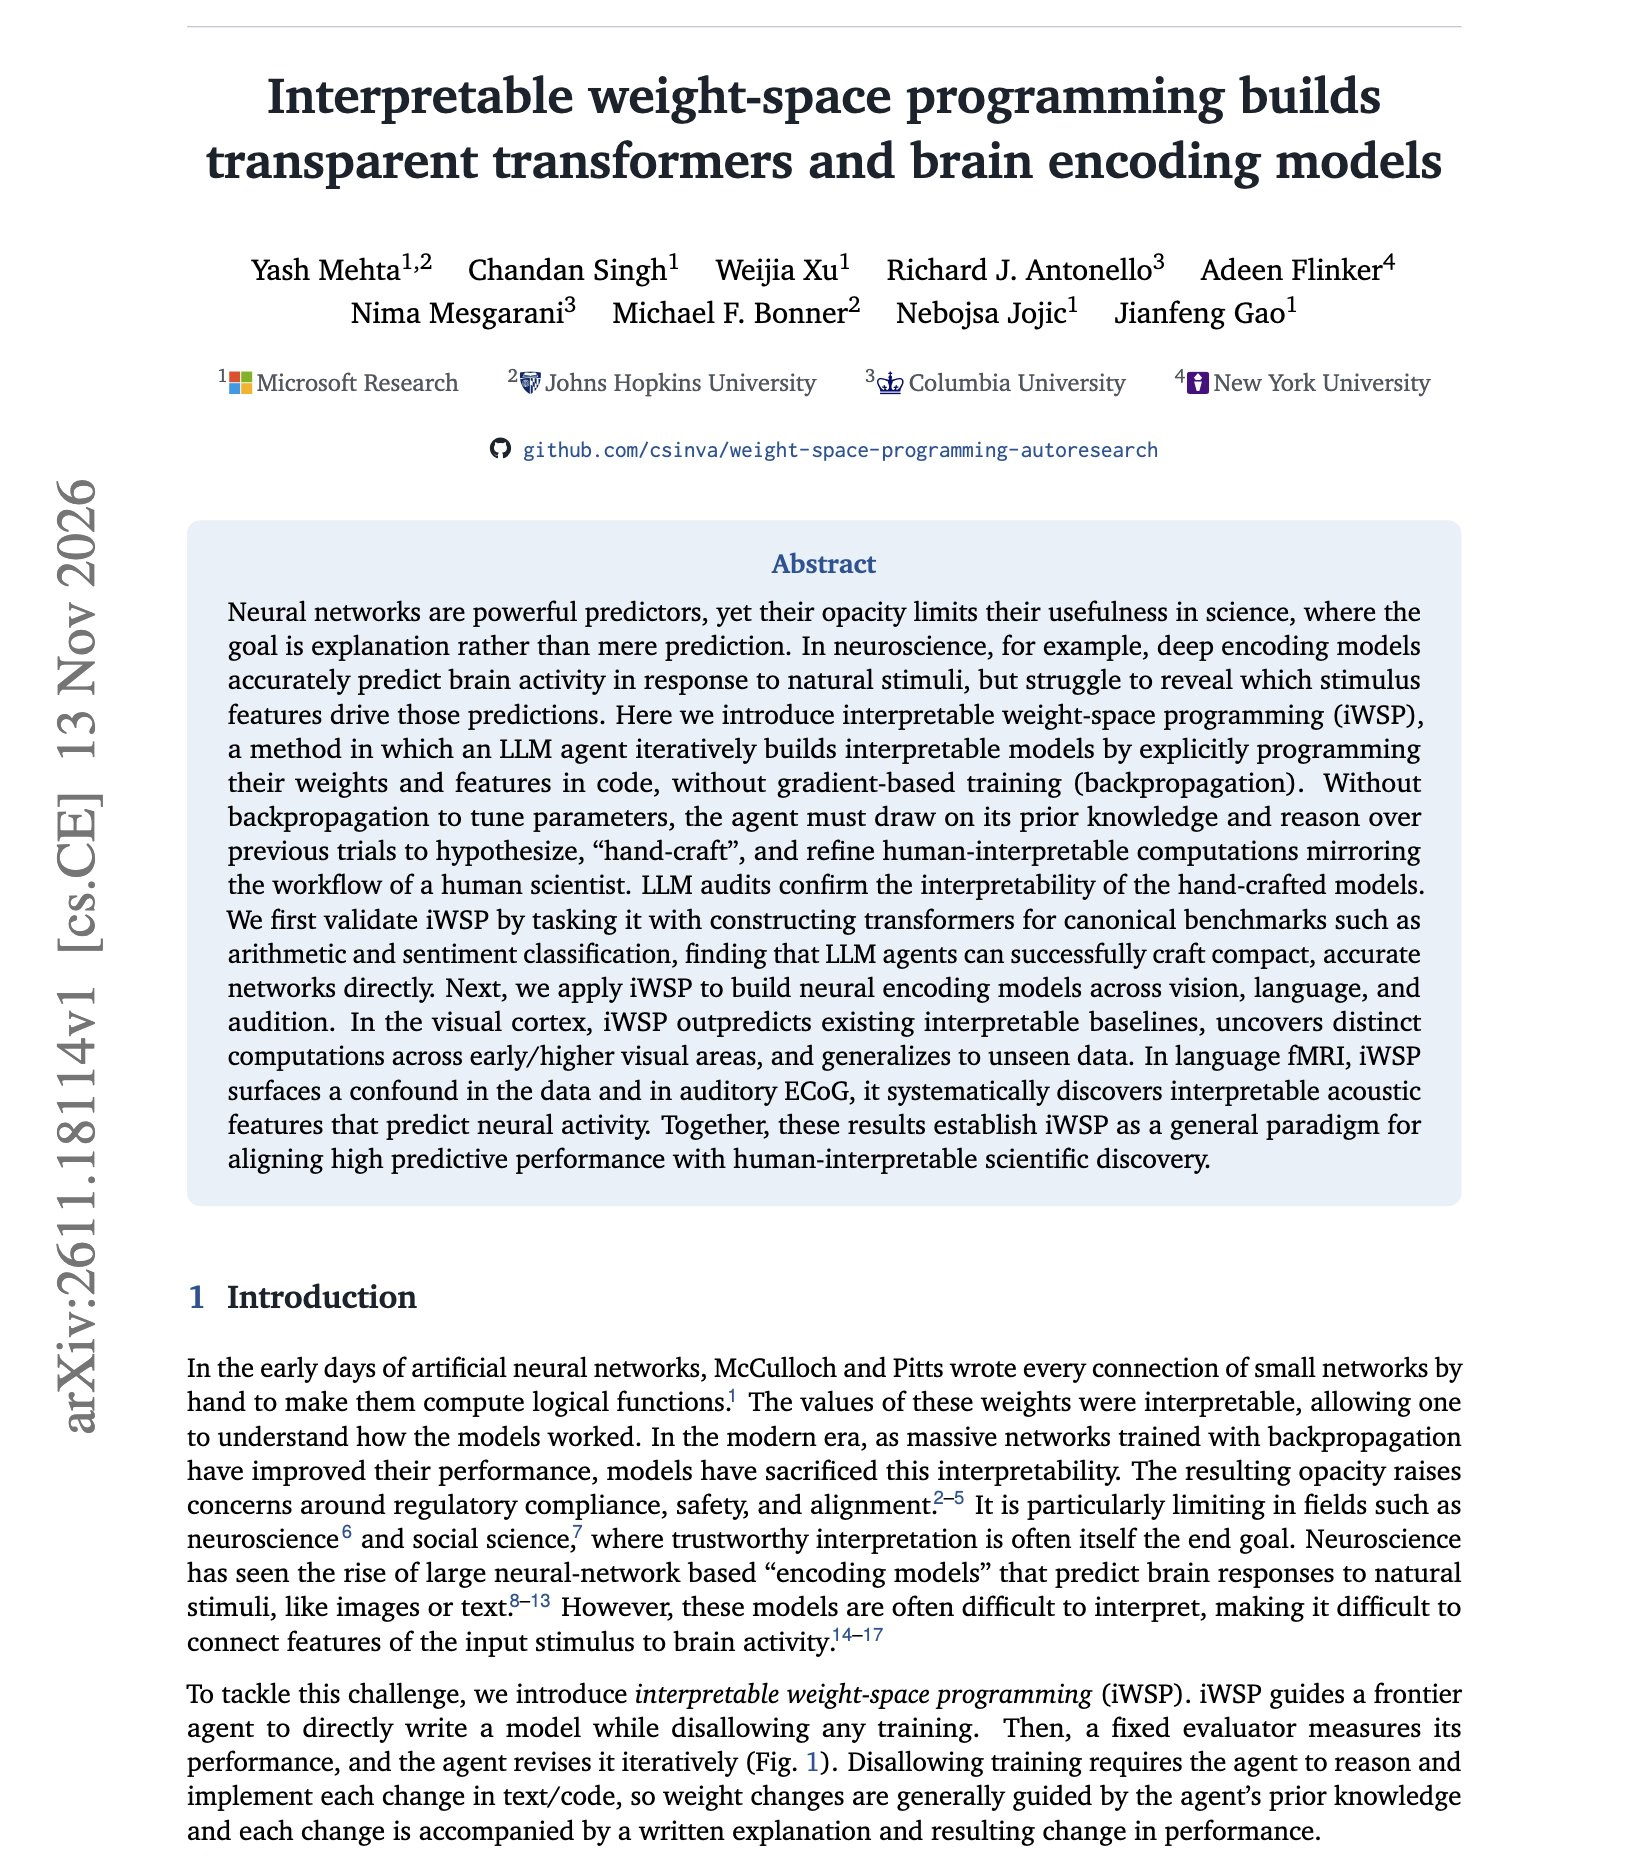
透明权重编程在特定算法任务中获得满分。 elvis分享的研究让代理直接编写权重和特征,通过30—50轮测试与修订完成模型构造,无需梯度训练。26次算法任务实验在保留数据上均达100%准确率;语言任务更困难,表现落后于训练所得基线。结果展示的是特定任务能力,并非普遍替代模型训练。
-
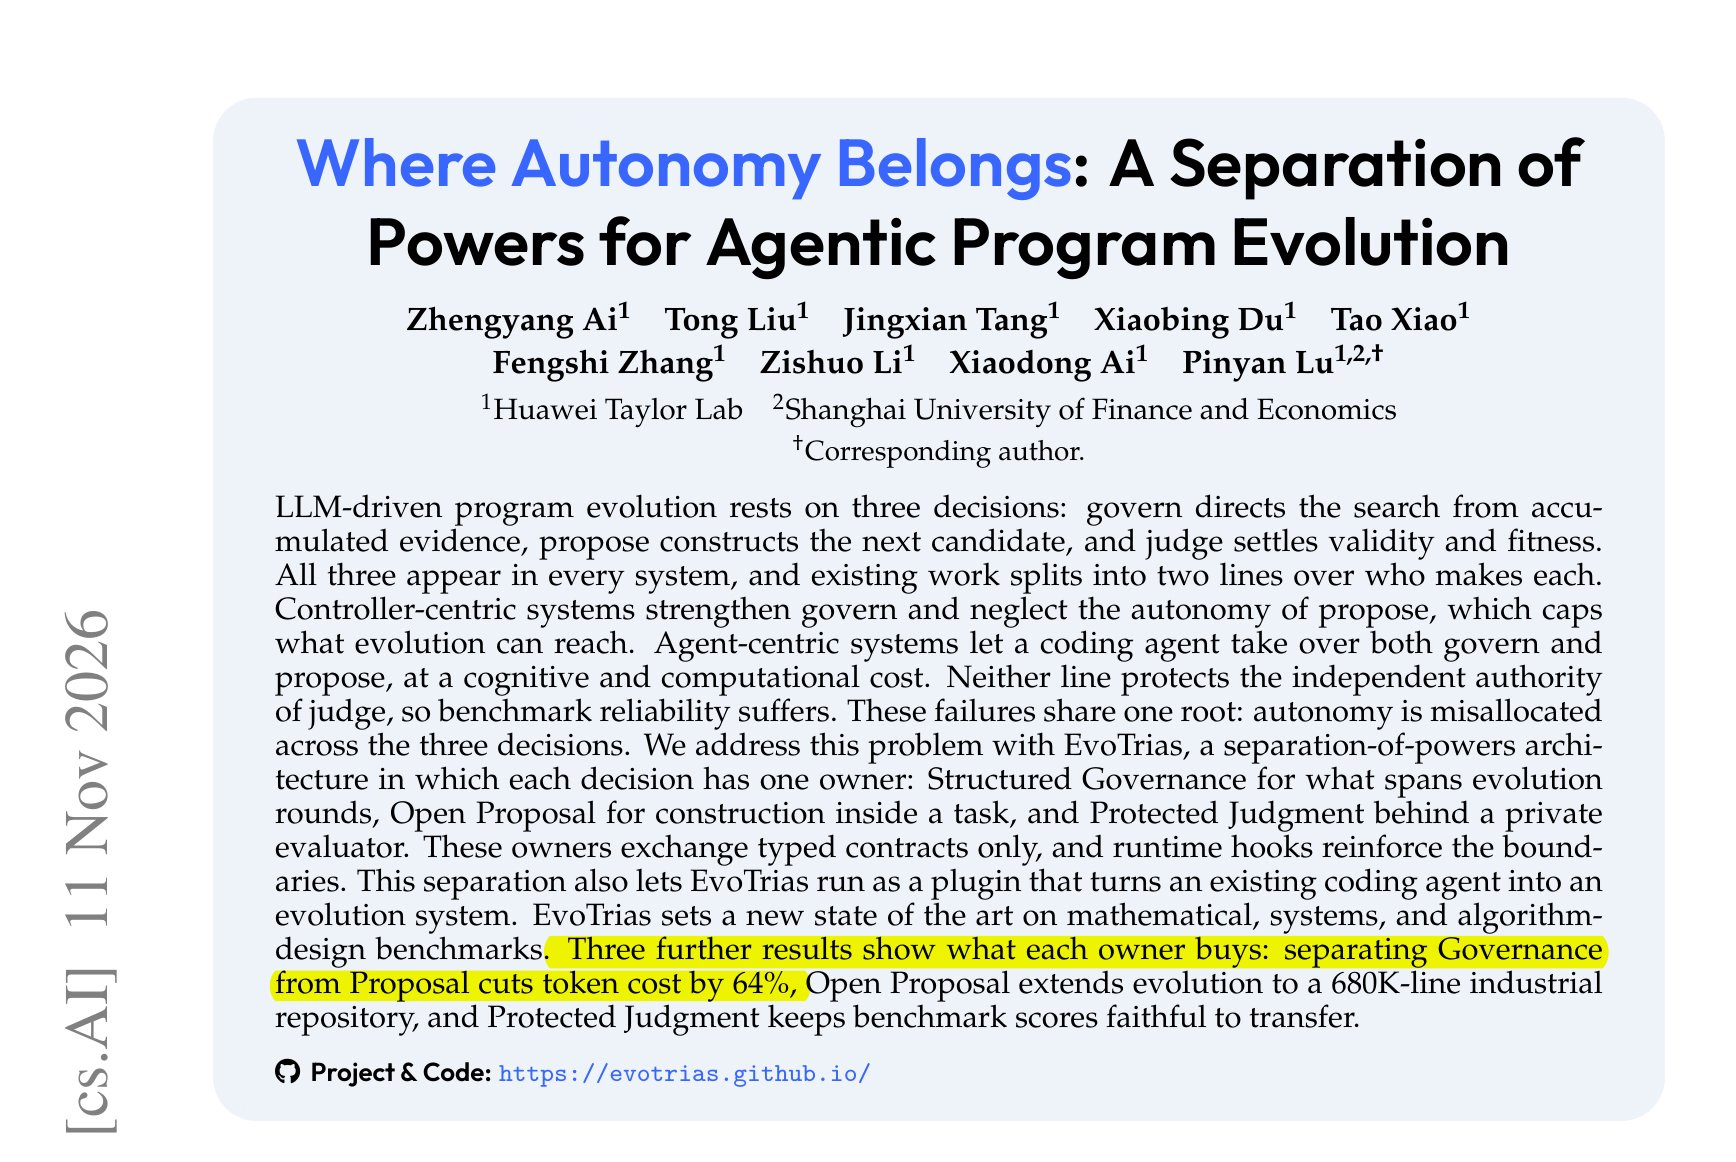
EvoTrias拆分规划、编码与评分职责。 据Rohan Paul介绍,华为论文中的EvoTrias将三个环节交给独立角色,编码代理接触不到评分器。所述七项数学任务中领先六项,单次运行令牌成本较四代理CORAL下降64%;在300个OR-Tools实例上,求解质量提升13.2%。以上为帖文转述的实验结果。
-
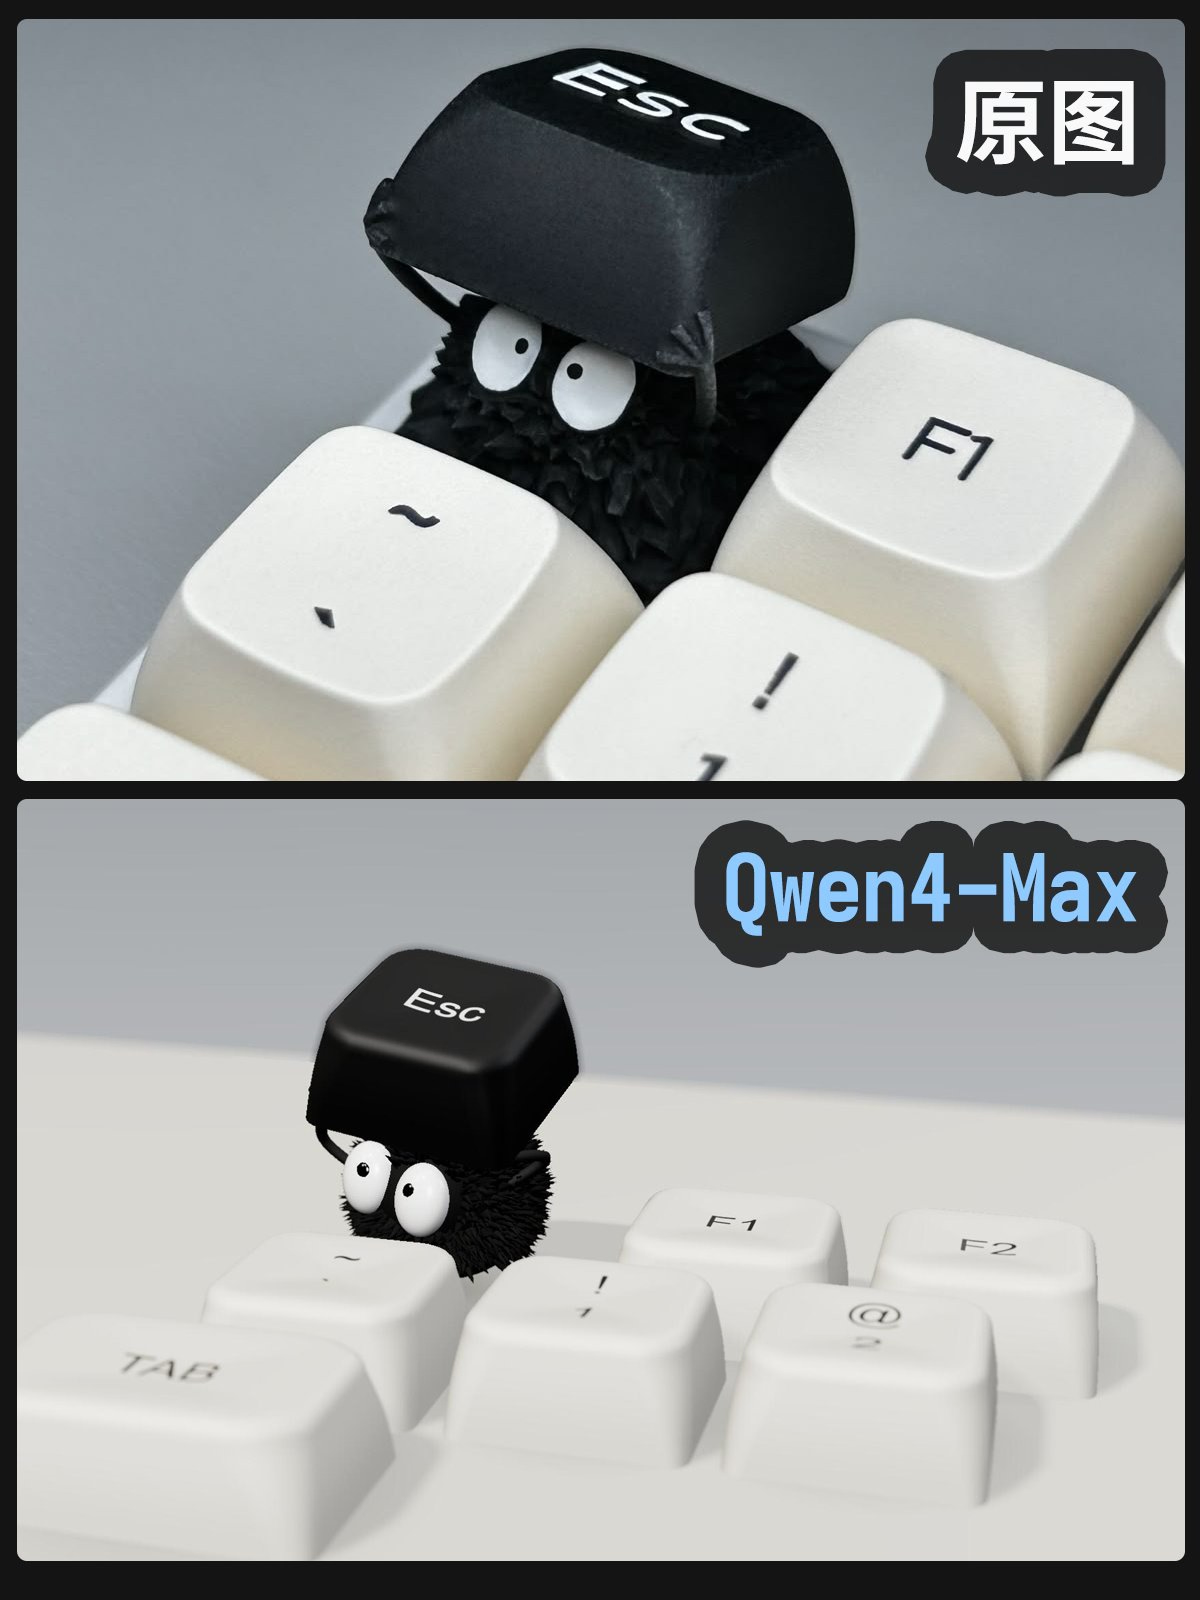
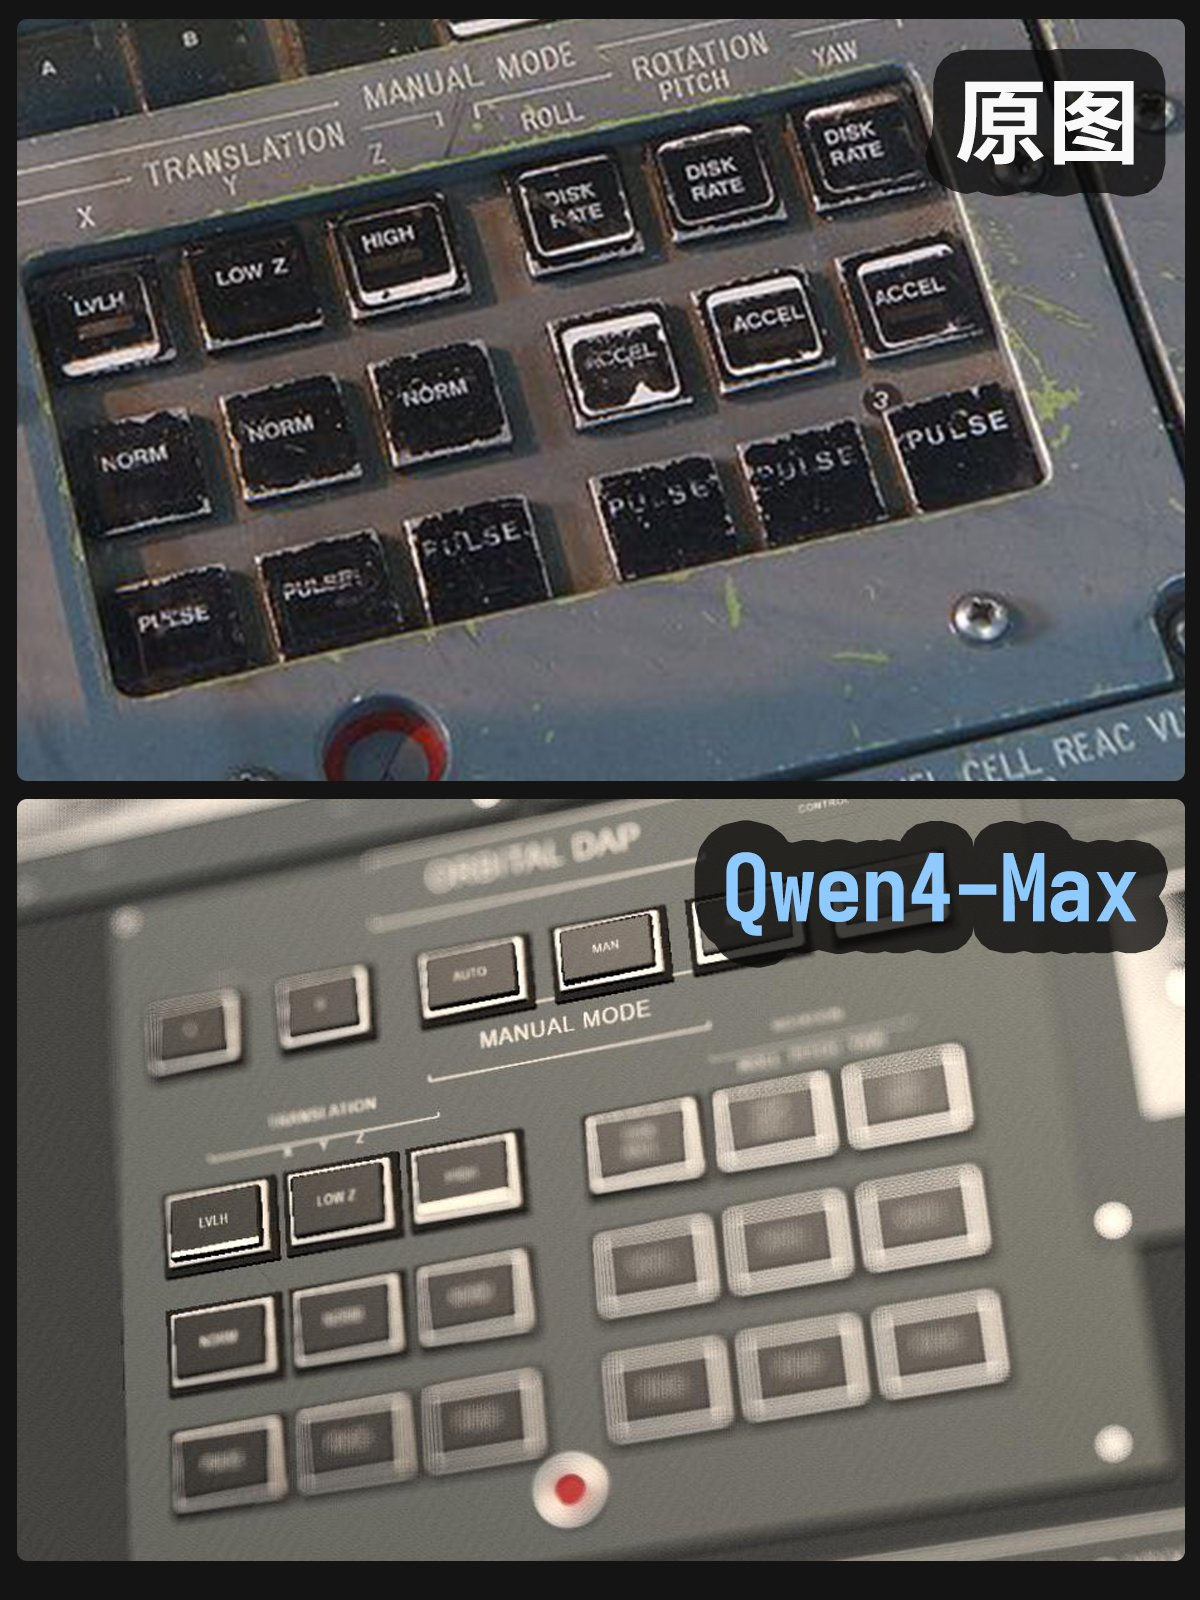
个人样例测试千问空间理解与三维复现。 karminski的测试让Qwen4-Max根据原图或原始视频生成Three.js场景。作者认为面板按键还原较好、推理令牌消耗较少,但视觉效果偏朴素。这属于个人样例观察,尚非统一基准结论。
-
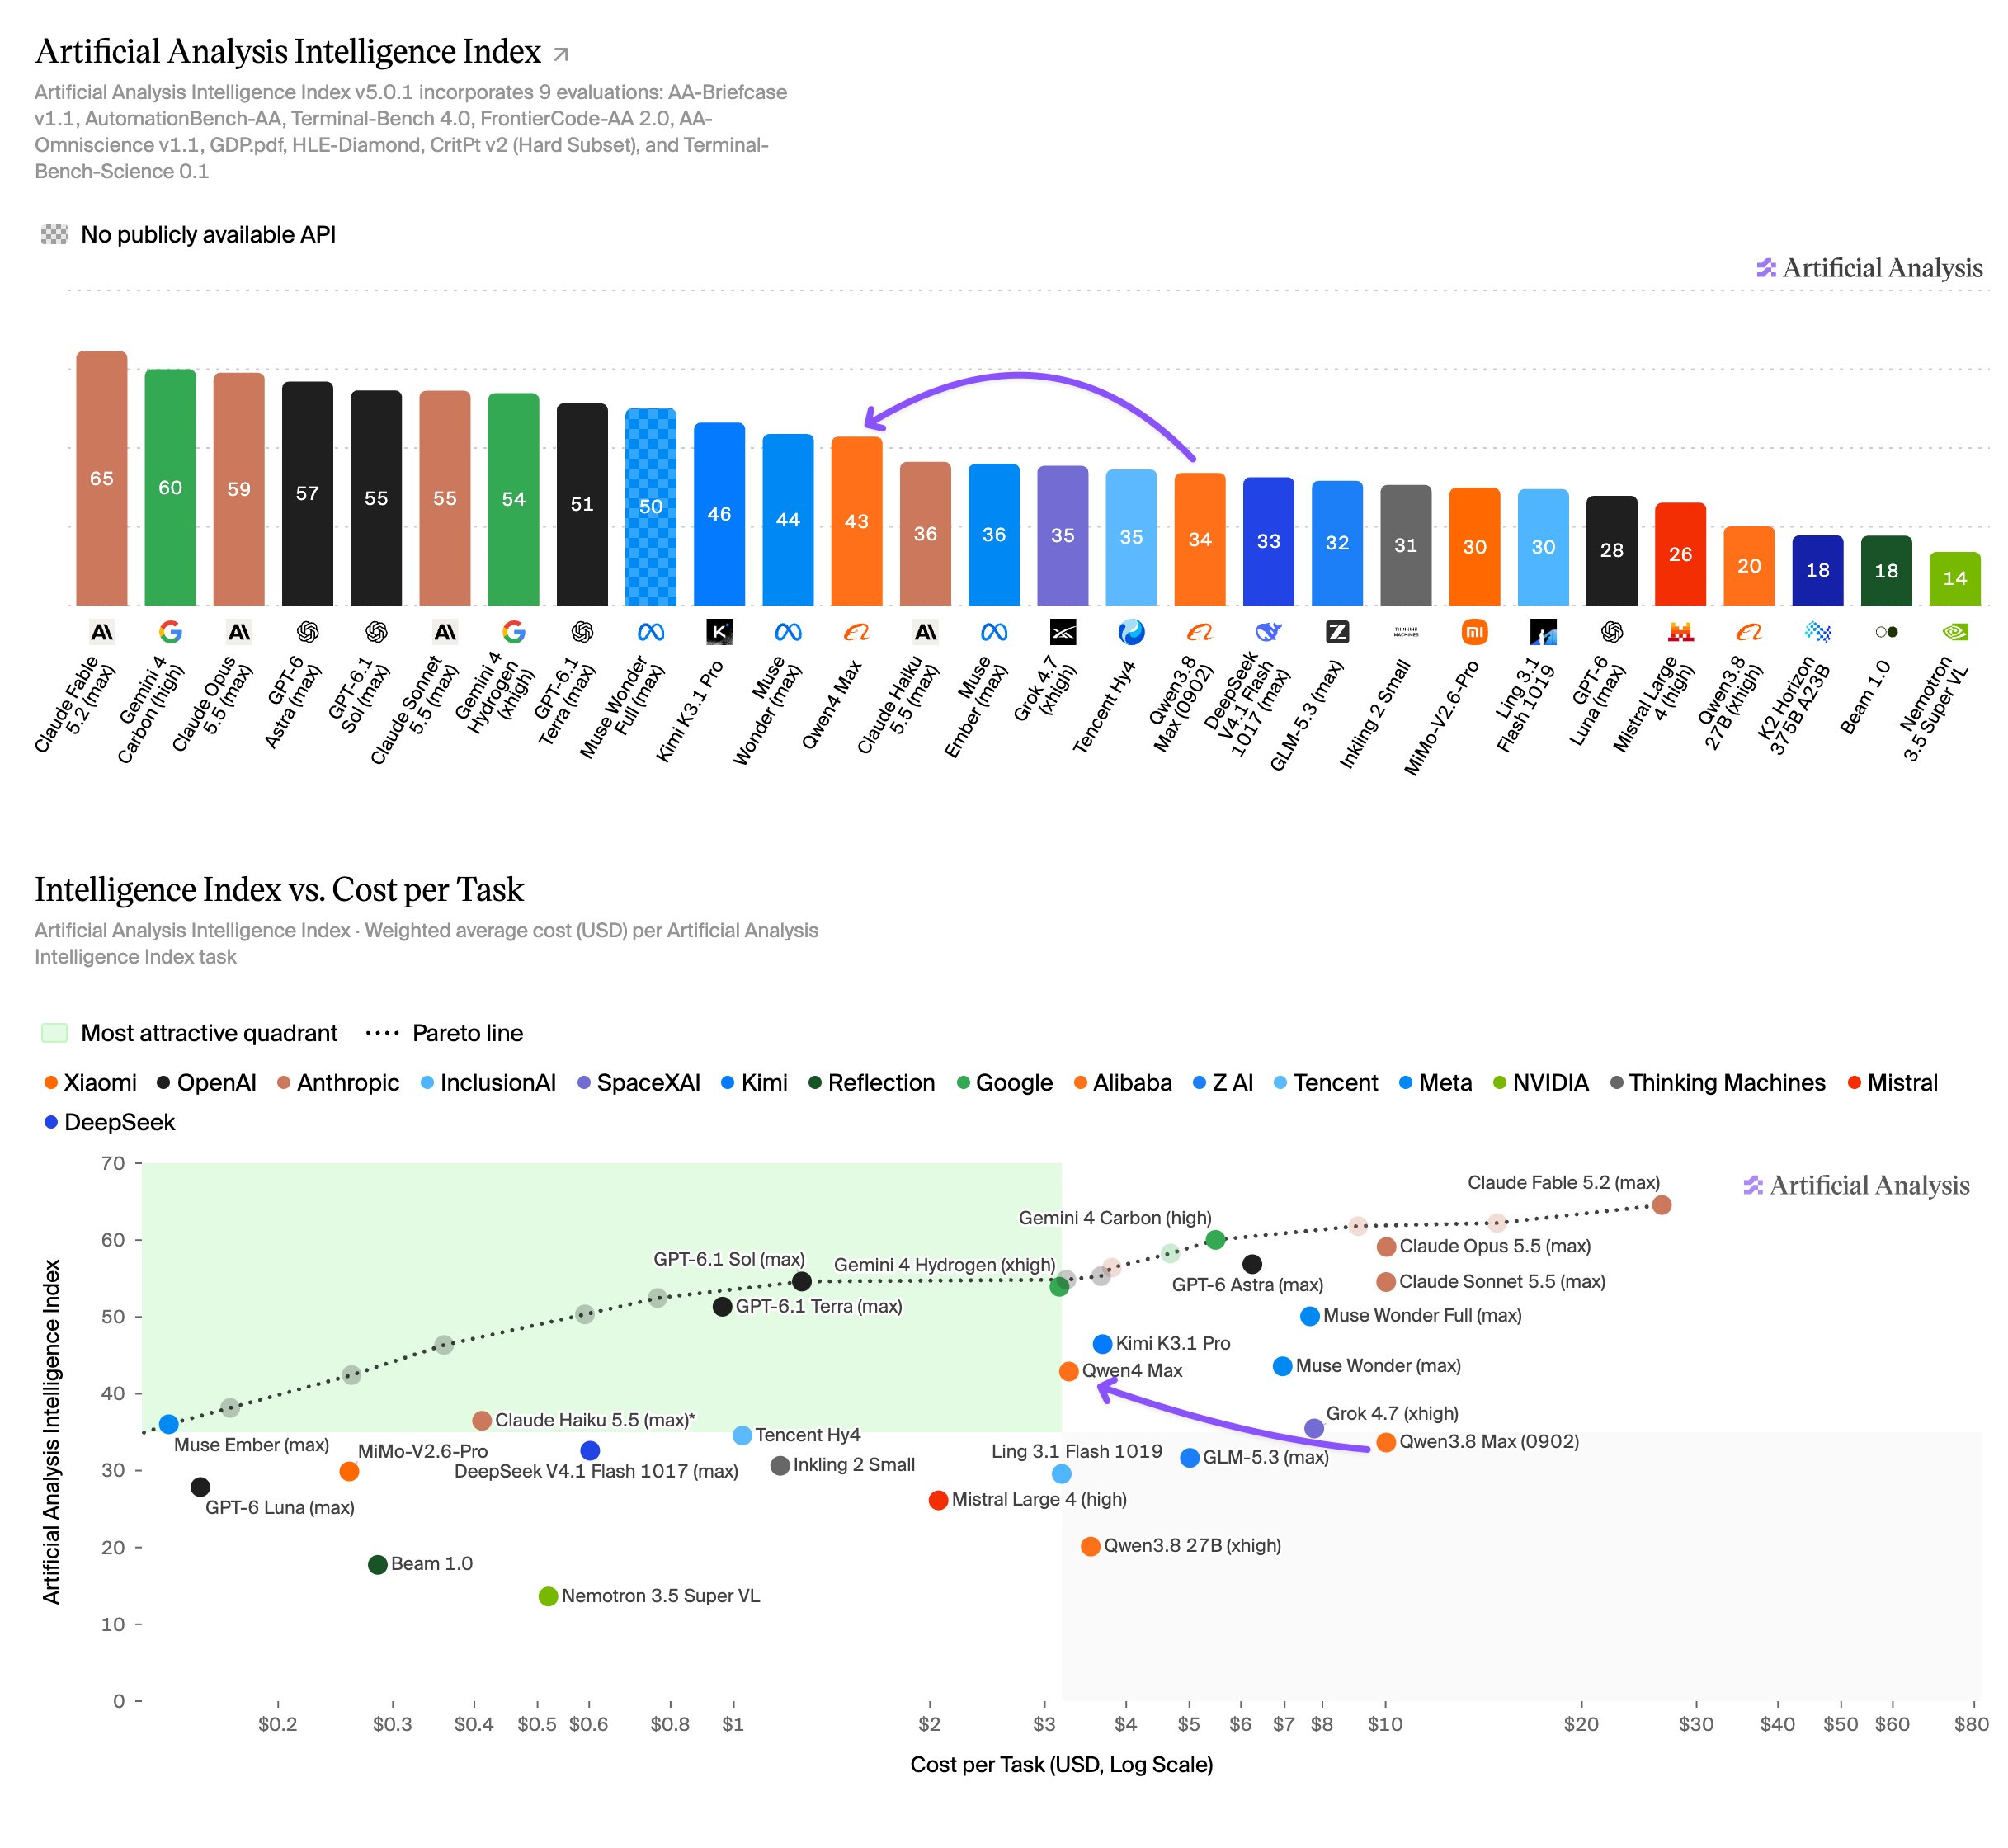
第三方数据讨论Qwen4 Max能力与成本。 Ethan Mollick转引的Artificial Analysis数据称,Qwen4 Max在xhigh推理设置下智能指数为43分,比Qwen3.8 Max高9分,输出令牌量减少39%。帖子同时比较不同模型的任务成本与编码表现;这些数值受评测集、推理设置和价格口径约束,不宜直接外推所有工作负载。
-
论坛转述美国拟扶持AI企业的政策消息。 一则Reddit讨论转述报道称,美国拟将二十余家AI企业列为“国家冠军”,支持措施可能包括出口许可提速、海外协助和联邦融资。作者将其与中国在APEC倡导自由贸易的表态对照。素材未附正式政策文件,拟议措施与作者评论应分开看待。
-
AI歌手登顶韩国Melon榜单的消息流传。 Reddit帖文标题称,AI歌手凭《Did You Become the Adult You Dreamed Of?》首次登顶Melon榜单。现有正文仅为投稿元信息,未提供榜单类型、日期或歌手身份细节,具体登榜口径仍待核实。
AI资讯日报多渠道
| 💬 微信公众号 | 📹 抖音 |
|---|---|
| 公众号:何夕2077 | 自媒体账号 |
 |  |